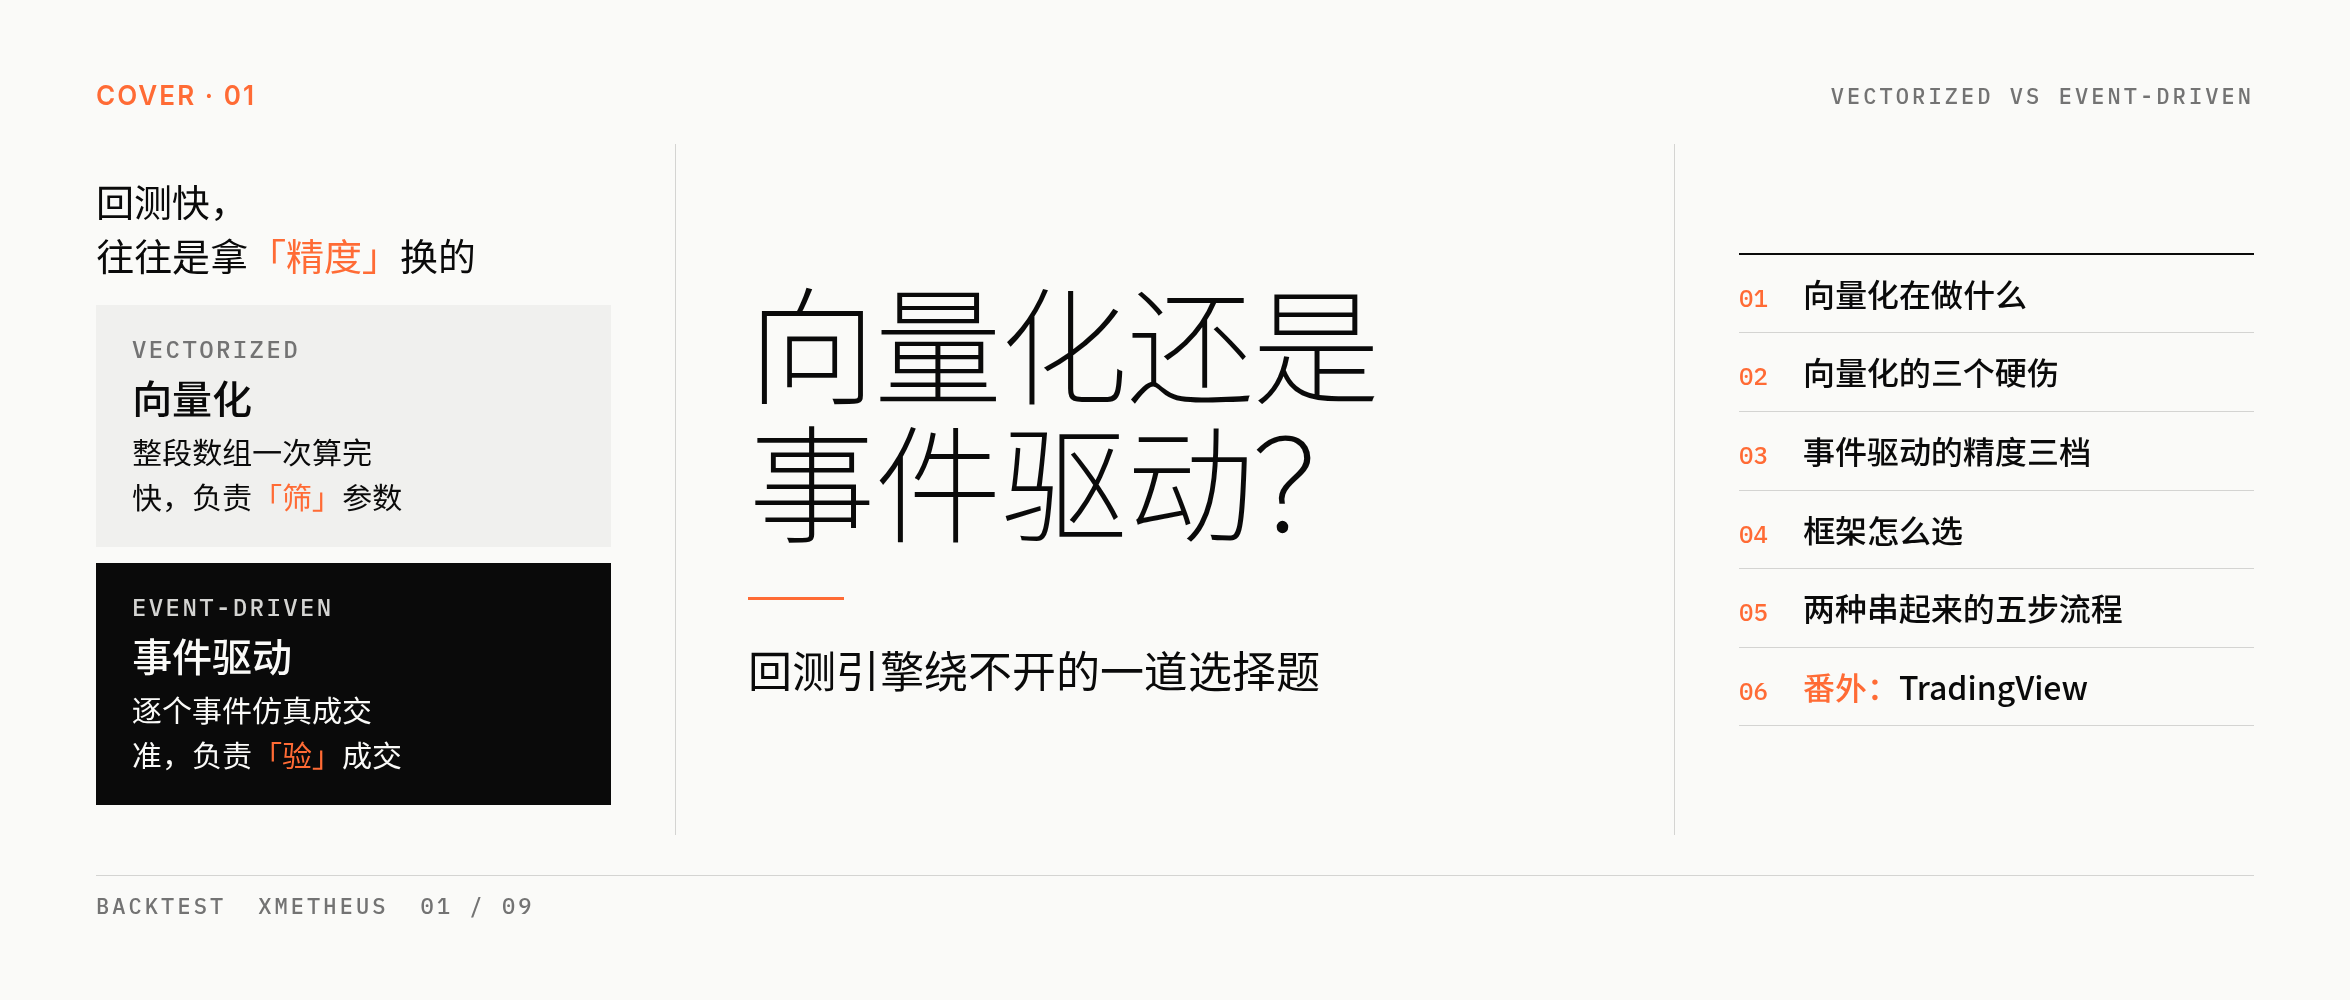
搭回测引擎会遇到很多问题,其中一个绕不开的,就是底层用哪种架构:向量化,还是事件驱动。
很多人第一次碰到这个问题,是发现同一个策略在两套工具里跑出了明显不同的曲线。通常不是哪边写错了,而是两种架构对”市场怎么运转”做了不同的假设。我把这两种架构拆开整理了一遍,顺便把容易踩、又不太容易被发现的坑也列出来。
先说结论:这不是二选一,它们更像流水线上的两道工序。向量化负责”筛”,事件驱动负责”验”。要用哪一种、要精细到什么程度,取决于你的收益对成交细节有多敏感。中低频策略,用 K 线回测就够了;日内策略,最好用逐笔成交数据;做市和高频靠挂单赚钱,能不能成交取决于排队位置,回测时得把订单簿也模拟出来。
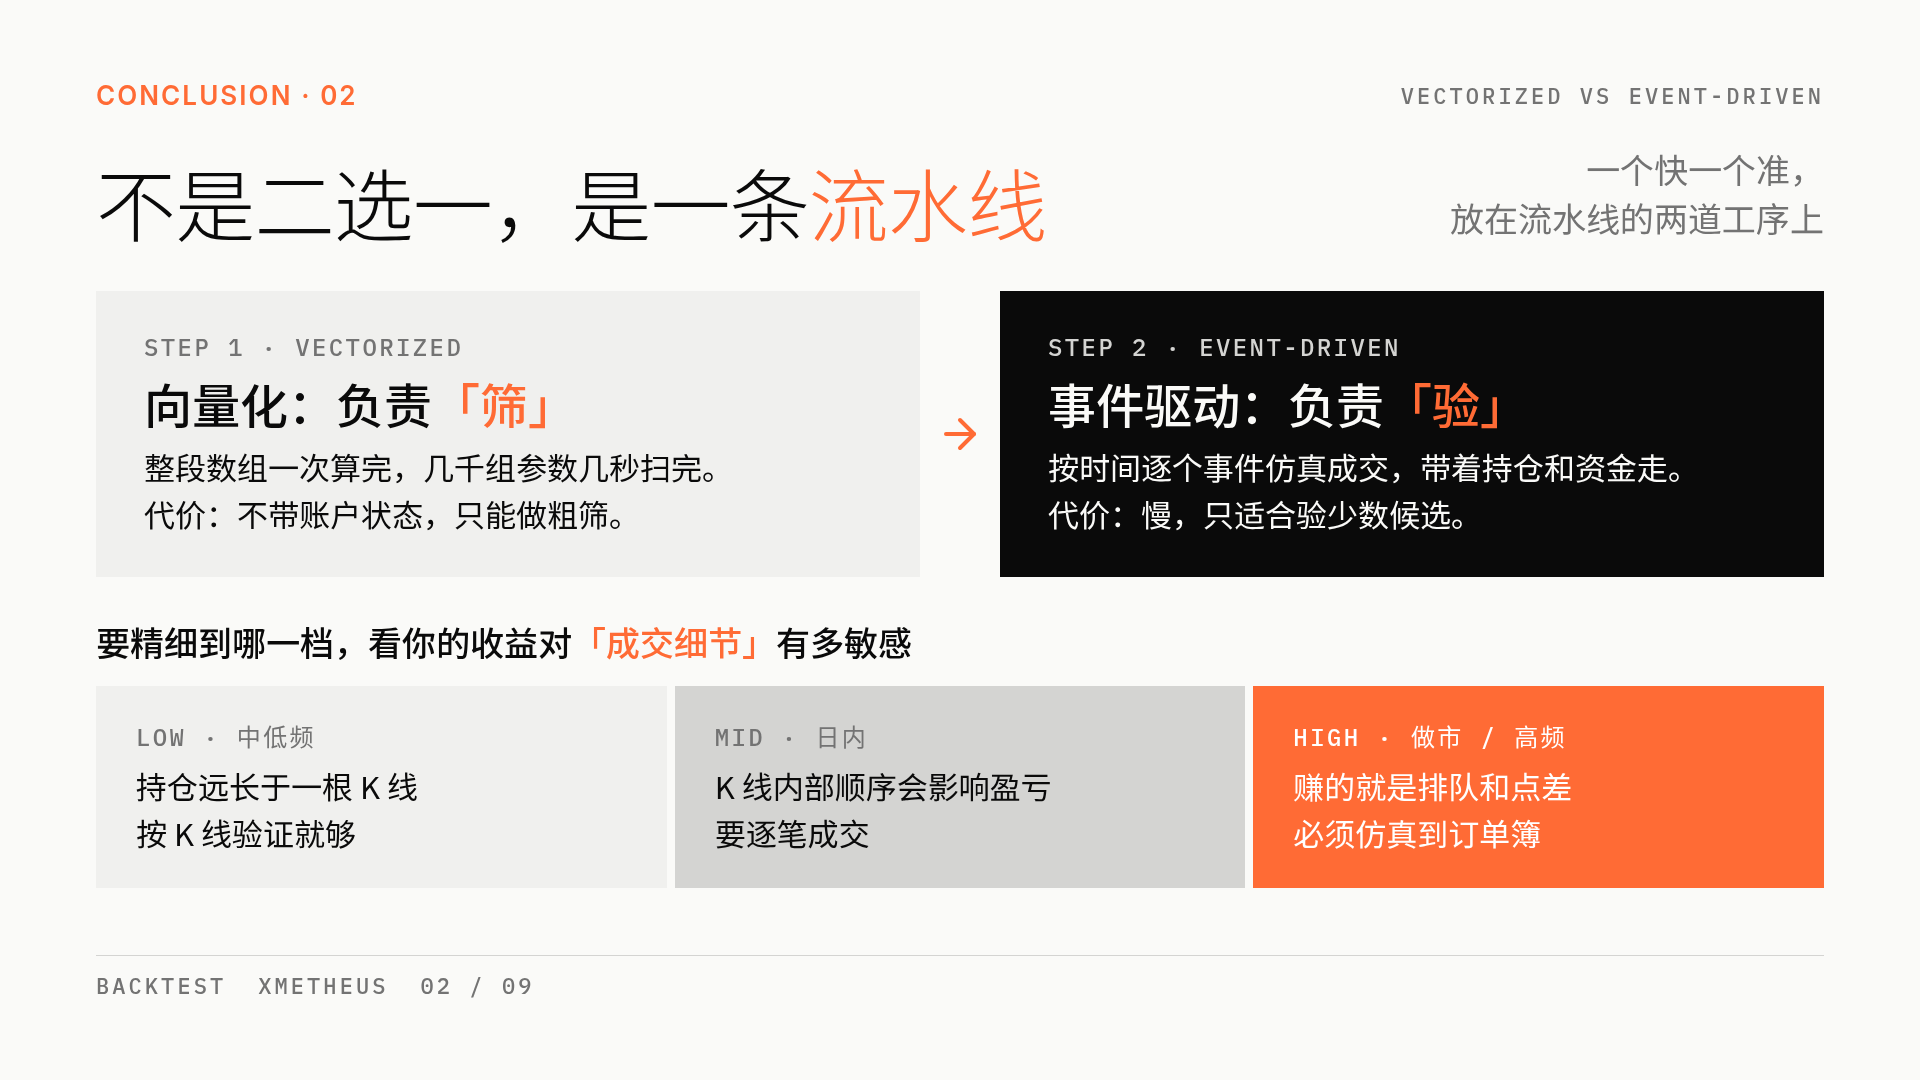
- 不是二选一,是一条流水线:向量化负责低成本筛参数,事件驱动负责带着账户状态验证成交,两者串起来用。
- 向量化的三个硬伤:未来函数、K 线内部路径、状态逻辑,根源都是默认每根 K 线互不依赖。
- 事件驱动也分三档精度:K 线、逐笔成交、订单簿仿真;价格碰到挂单价不等于成交,做市高频必须到第三档。
- 框架按需选:先定需要第几档精度、要不要同一套代码上实盘;Backtrader 已基本停更(最后提交 2023 年 4 月)。
- 五步流程闭环:扫参数 → 样本外 + DSR → 事件驱动验证 → 小资金实盘 → 逐笔对账,用偏差反向校准滑点和延迟。
一、向量化到底在做什么
向量化回测把整段行情当成一个数组。价格是一列,用规则一次算出信号列,信号整体往后错一格变成持仓列,持仓乘以涨跌得到收益列,最后累加成净值。整个过程没有一根一根往前走的循环,全部交给 NumPy 或 Numba 做批量运算。
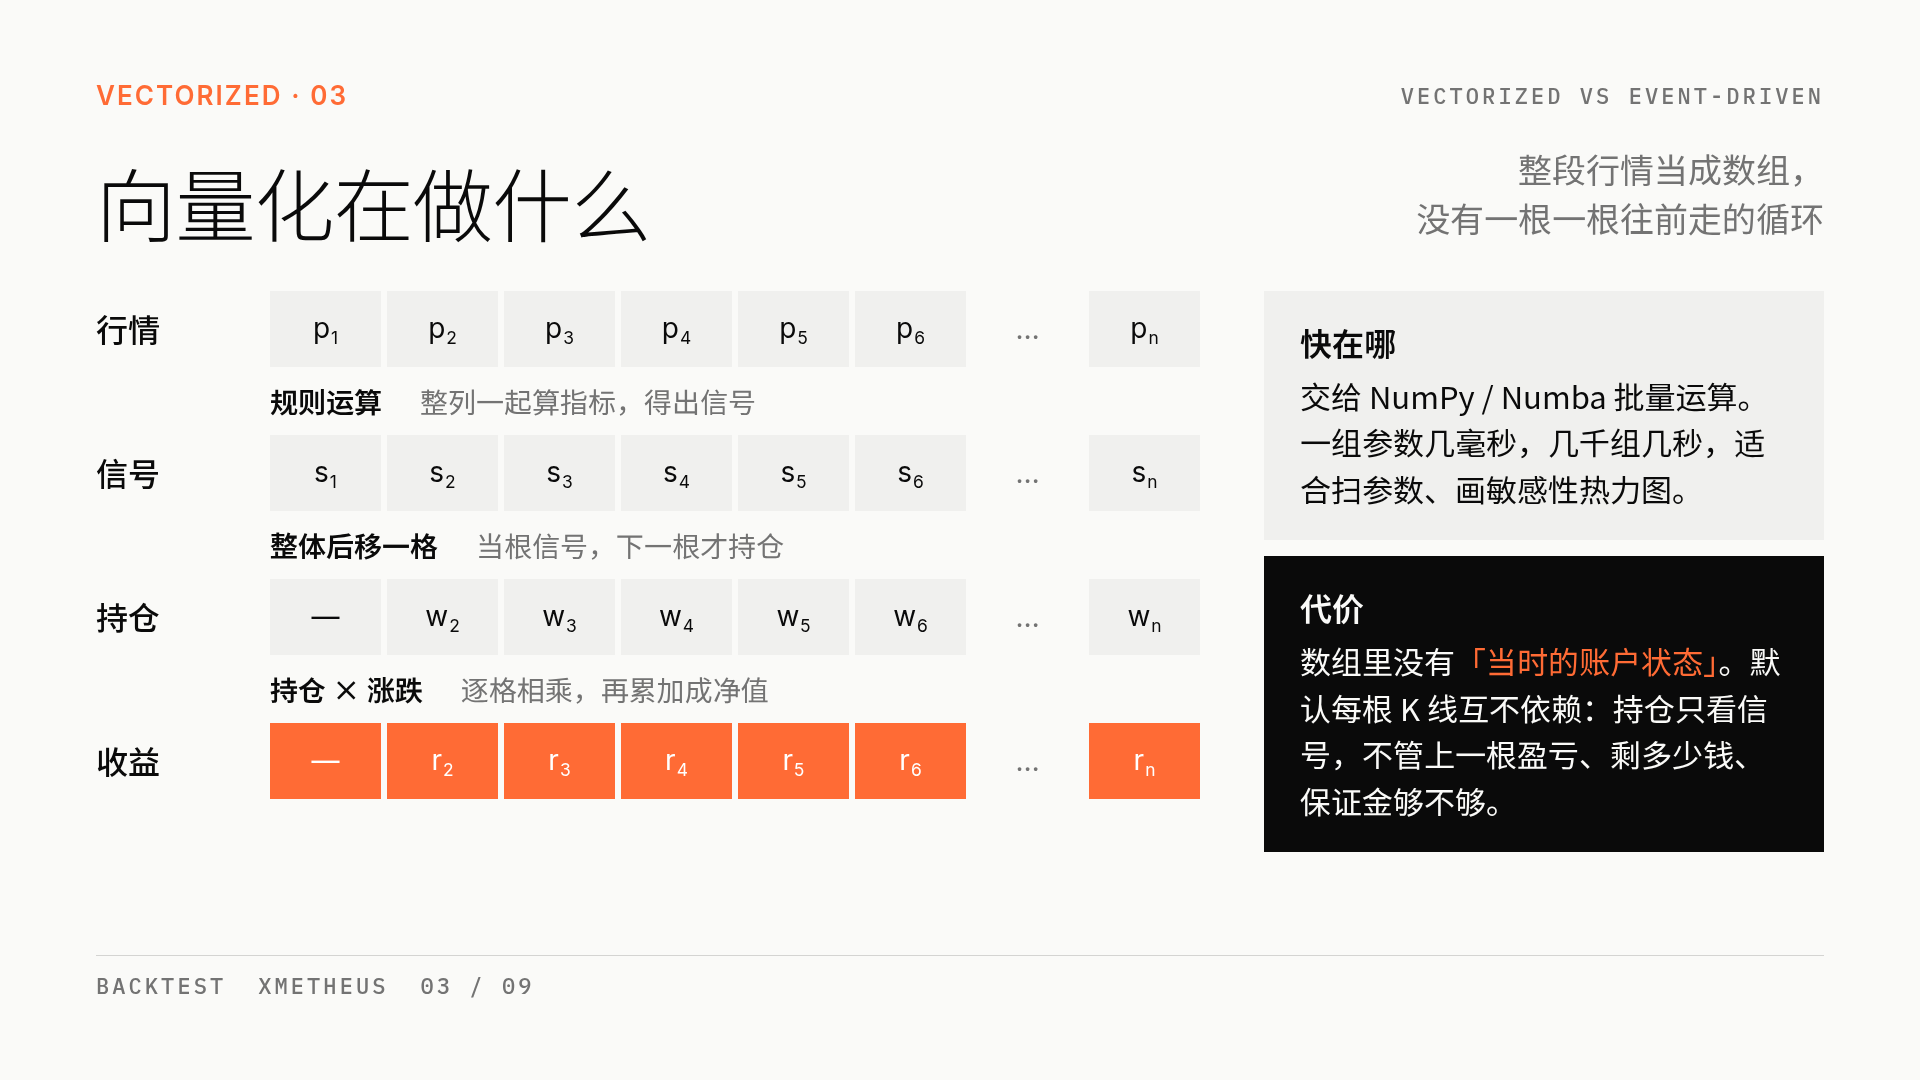
快就快在这里。一组参数几毫秒,几千组参数几秒钟扫完,做参数敏感性、画热力图都很顺手。
代价也在这里。数组里没有”当时的账户状态”这个东西。它默认每根 K 线互不依赖:这一根的持仓只由信号决定,跟你上一根赚了还是亏了、账户里还剩多少钱、保证金够不够都没有关系。只要策略逻辑开始依赖路径,向量化就得硬塞,越塞越容易出错。
二、向量化的三个硬伤
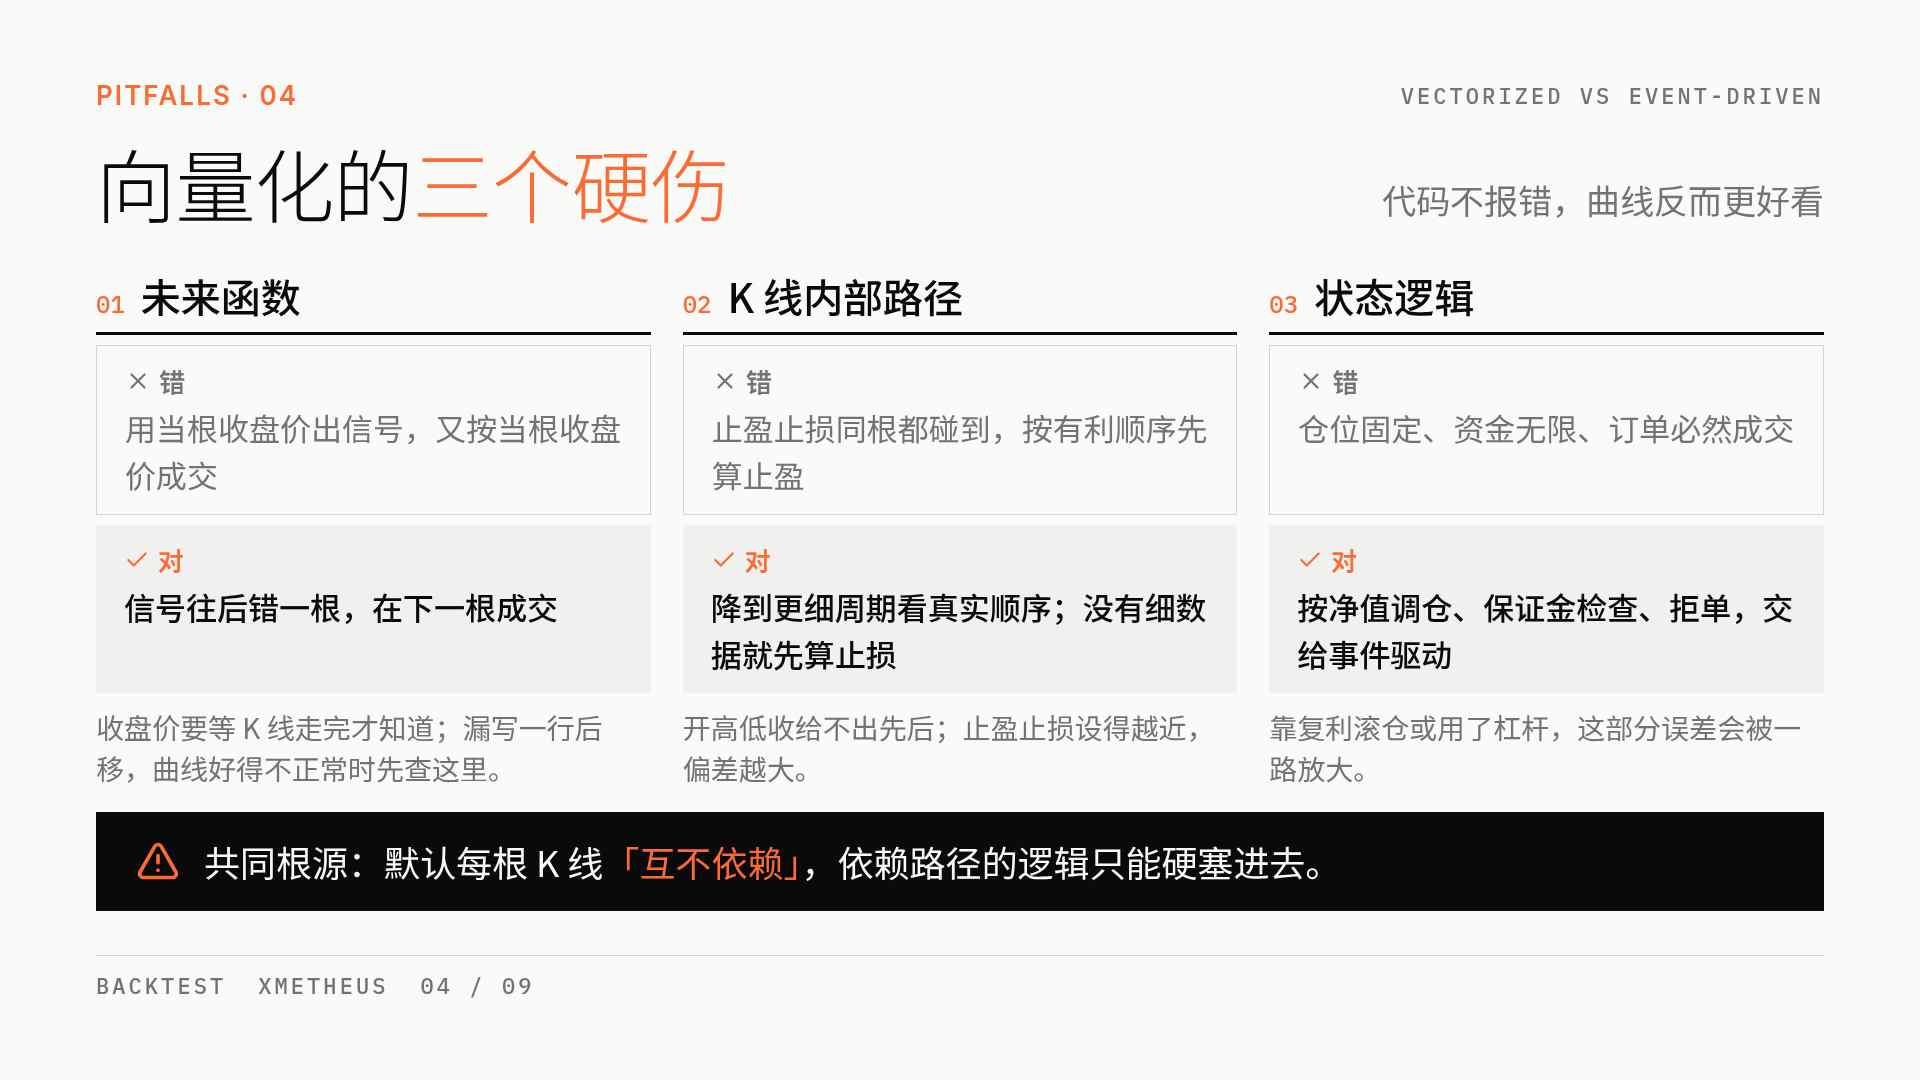
1. 未来函数。 最常见的写法是用当根收盘价算信号,再按当根收盘价成交。看起来很自然,问题是收盘价要等这根 K 线走完才知道,你不可能在知道它之后还用它成交。正确做法是信号往后错一根,在下一根成交。这个错误在向量化里特别隐蔽,因为一行 shift 写漏了,代码不会报错,曲线反而会更好看。曲线好得不正常时,第一件事就是查这个。
2. K 线内部路径。 同一根 K 线里,最高价碰到了止盈,最低价碰到了止损,到底哪个先触发?开高低收四个数字给不出答案,只能靠假设。成熟的框架一般会把规则写明,比如 VectorBT 两边都碰到时保守地算止损,TradingView 则按开盘价离最高价近还是离最低价近来推断先走哪边。最容易出问题的是自己手写的向量化回测:判断语句的先后随手一写,很可能就成了先判止盈,等于每次都替自己选了有利的那条路径。比较老实的处理有两种:降到更细的周期去看真实顺序;或者在拿不到细数据时按最坏情况算,默认先止损。止盈止损设得越近,这个问题越严重。
3. 状态逻辑。 仓位按净值的百分比调整、保证金检查、交易所拒单,这些都依赖”上一刻发生了什么”。向量化里通常假设仓位固定、资金无限、订单必然成交。如果策略本身靠复利滚仓,或者用了杠杆,这部分误差会被一路放大。这类逻辑与其在向量化里打补丁,不如直接交给事件驱动。
三个问题有同一个根源:向量化默认每根 K 线互不依赖,而依赖路径的逻辑只能硬塞进去。
三、事件驱动在做什么
事件驱动换了一种思路:不再一次算完,而是模拟时间往前走。一个时钟按时间顺序分发事件,行情事件(K 线、逐笔或者订单簿更新)送给策略,策略决定下单(市价、限价、撤单),撮合模块按设定的精度模拟成交,成交回报再回来更新持仓和资金,然后进入下一个事件。
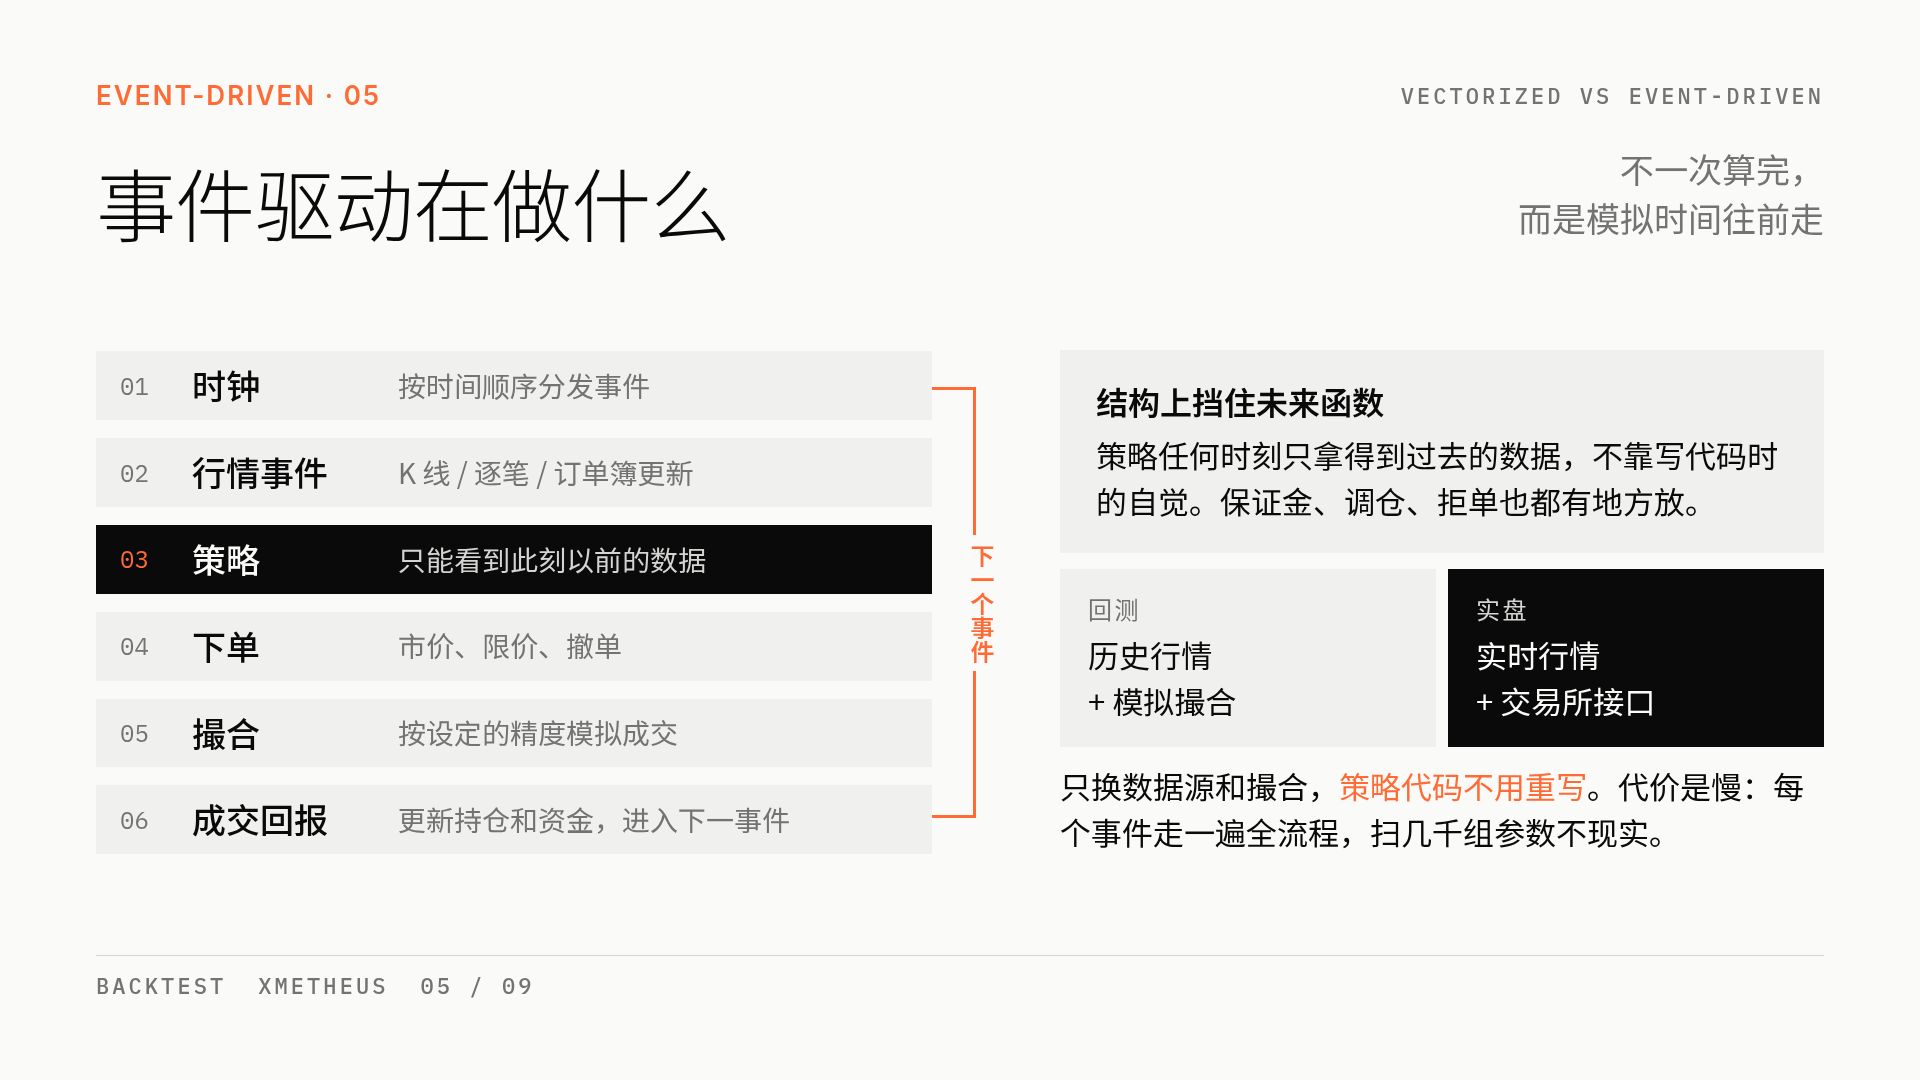
它最大的好处是结构上的。策略在任何时刻只能看到此刻以前的数据,未来函数从架构层面就被挡住了,不依赖你写代码时的自觉。账户状态也是一路带着走的,保证金、仓位调整、拒单这些都有地方放。
还有一个容易被低估的好处:回测和实盘可以共用同一套策略代码。回测时接历史行情和模拟撮合,实盘时把数据源换成实时行情、把撮合换成交易所接口,策略本身不用改。很多”回测好好的、实盘不对”的问题,其实出在策略被重写了一遍。
缺点就是慢。每个事件都要走一遍完整流程,Python 写的引擎跑一个品种几年的分钟线可能要几分钟,拿来扫几千组参数不现实。
四、事件驱动内部也分三档精度
很多人以为用了事件驱动就”准”了,其实事件驱动内部的精度差别很大,大致分三档。
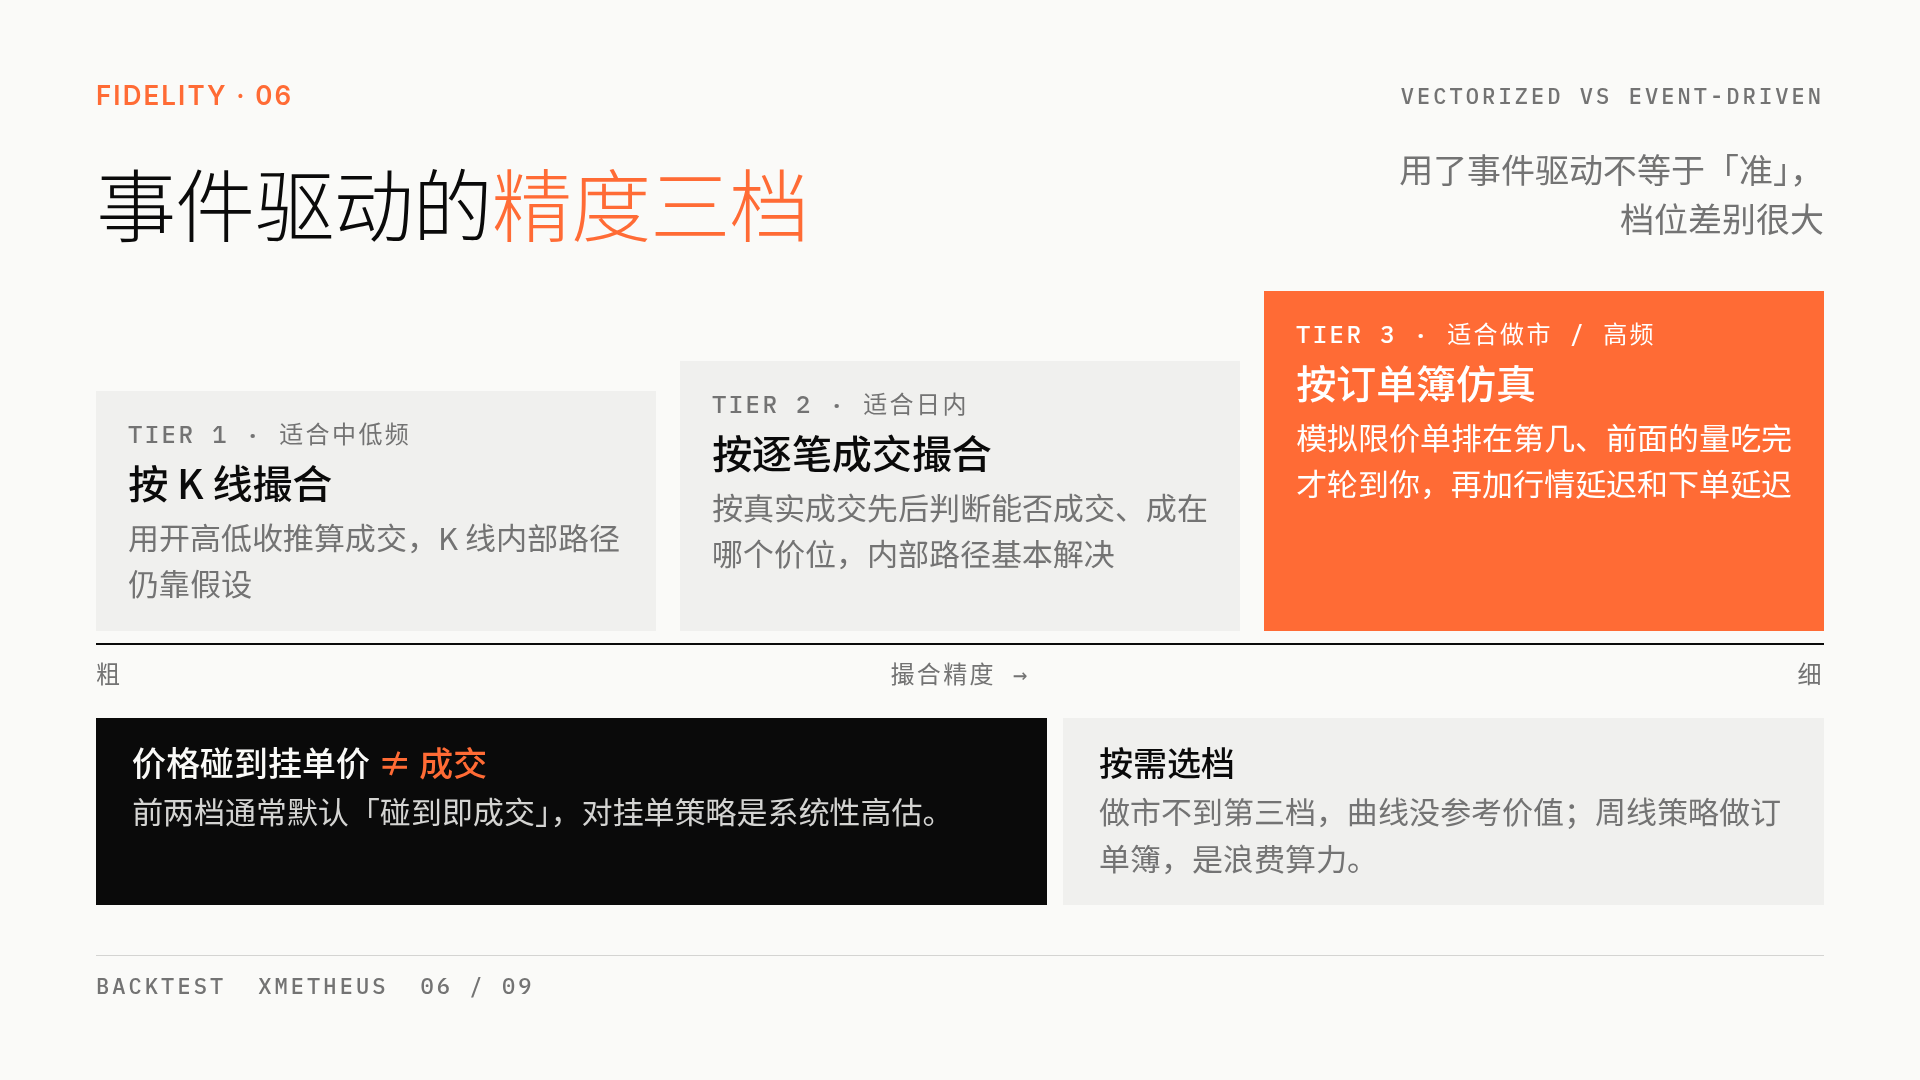
第一档,按 K 线撮合。 用开高低收推算成交,K 线内部的路径还是靠假设。适合中低频,持仓周期远大于一根 K 线时,这点误差可以接受。
第二档,按逐笔成交撮合。 按真实成交的先后顺序判断你的单子能不能成、成在哪个价位。K 线内部路径的问题基本解决,适合日内策略。
第三档,按订单簿仿真。 除了逐笔成交,还要模拟你的限价单在队列里排第几、前面的量被吃掉多少才轮到你,再加上行情延迟和下单延迟。这里有个容易忽略的细节:价格碰到你的挂单价,不等于你成交了,前面排队的量没吃完,你一手都拿不到。第一、二档通常默认”碰到即成交”,这对挂单策略是系统性高估。
所以做市和高频如果做不到第三档,回测曲线基本没有参考价值。反过来,一个周线级别的策略去搞订单簿仿真,也是浪费算力。
五、开源框架怎么选
我按类型、内核、精度、能否用同一套代码上实盘,把几个常见框架列了一下:
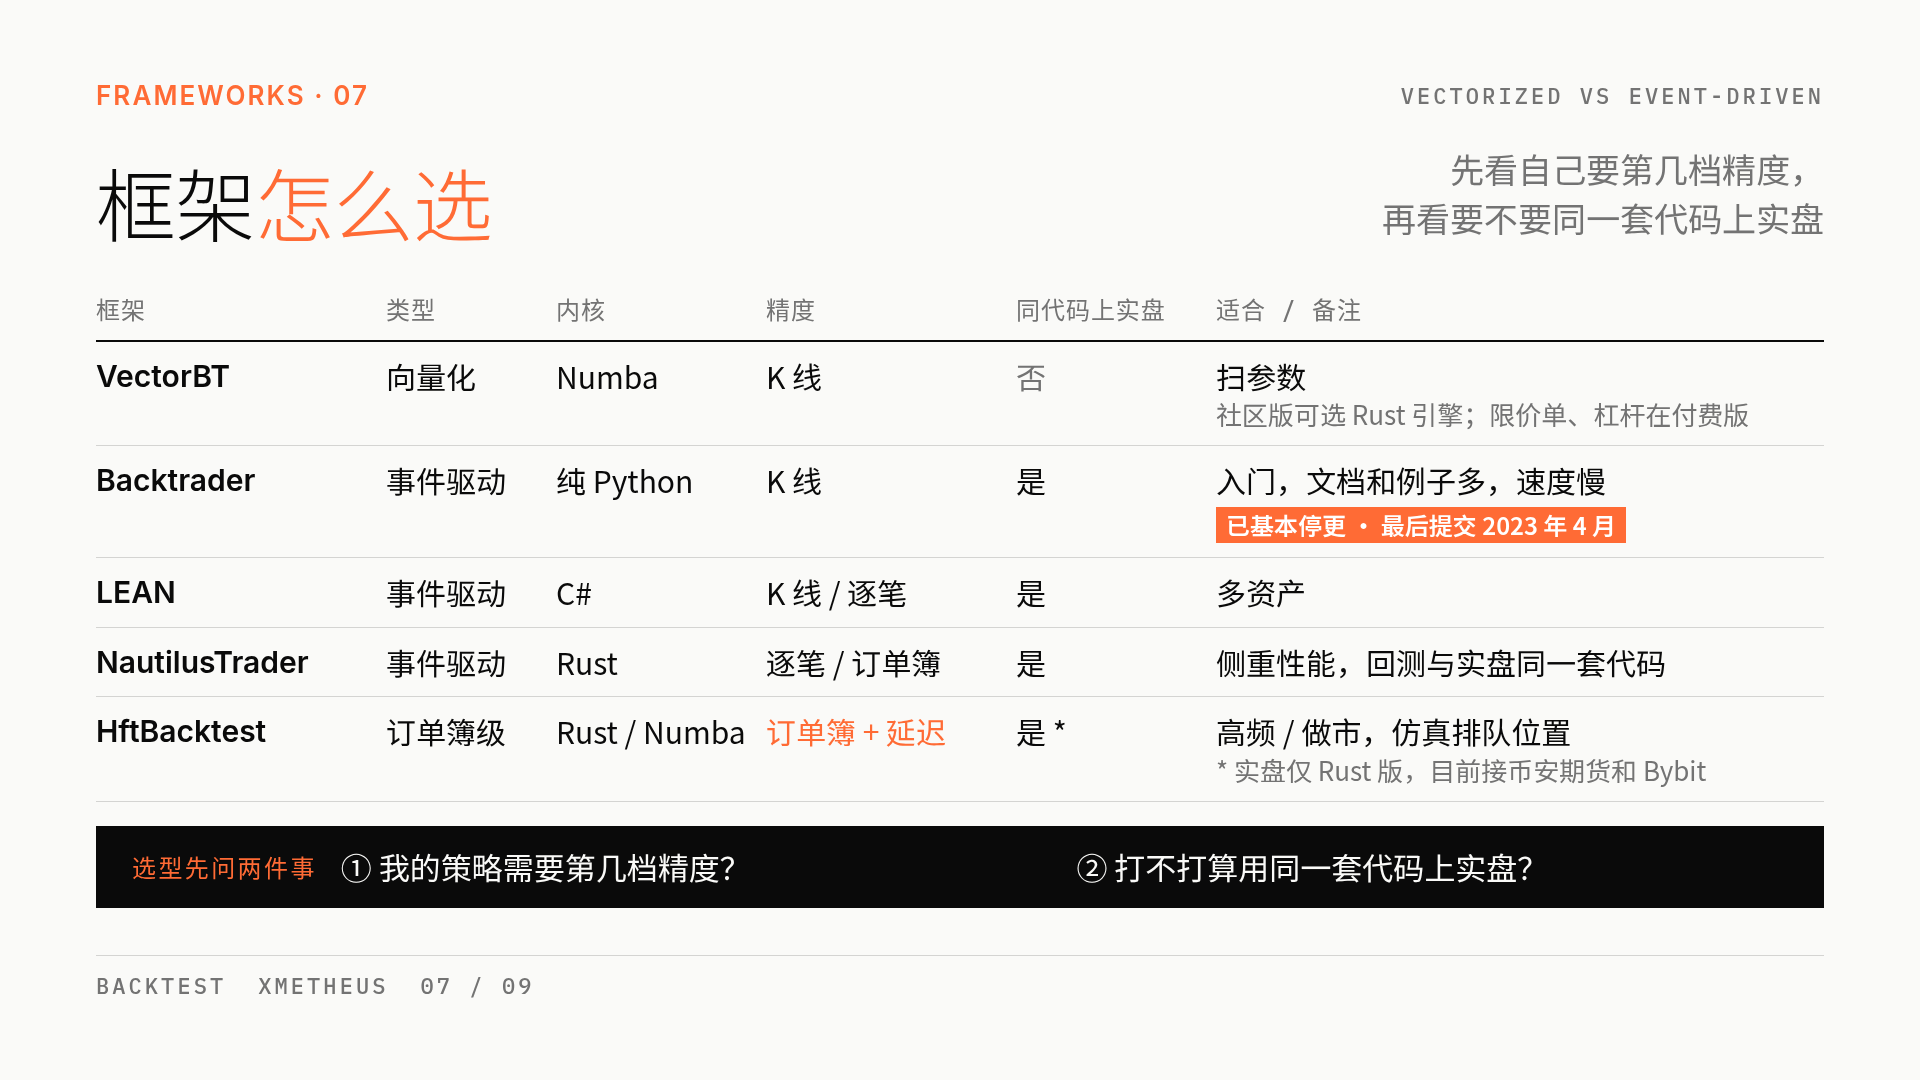
- VectorBT:向量化,Numba 内核,K 线精度,不能直接接实盘,最适合扫参数。社区版可以选 Rust 引擎,但限价单、杠杆这些功能在付费版里。
- Backtrader:事件驱动,纯 Python,K 线精度,能接实盘。文档和例子多,适合入门,但速度慢,而且项目已基本停更(最后一次提交在 2023 年 4 月,之后没有再发新版本)。
- LEAN:事件驱动,C# 内核,K 线和逐笔都支持,能接实盘,适合多资产。
- NautilusTrader:事件驱动,Rust 内核,精度到逐笔成交和订单簿,回测与实盘同一套代码,侧重性能。
- HftBacktest:订单簿级别,内核是 Rust 和 Numba,精度到订单簿加延迟,会仿真排队位置,适合高频和做市。要注意它的实盘只有 Rust 版,目前接的是币安期货和 Bybit。
选的时候别先看哪个热门,先问自己两个问题:我的策略需要第几档精度?我打不打算用同一套代码上实盘?这两个答案基本就把范围缩到一两个了。
六、比较稳的做法:两种串起来用
既然一个快一个准,比较稳的做法就是串起来。
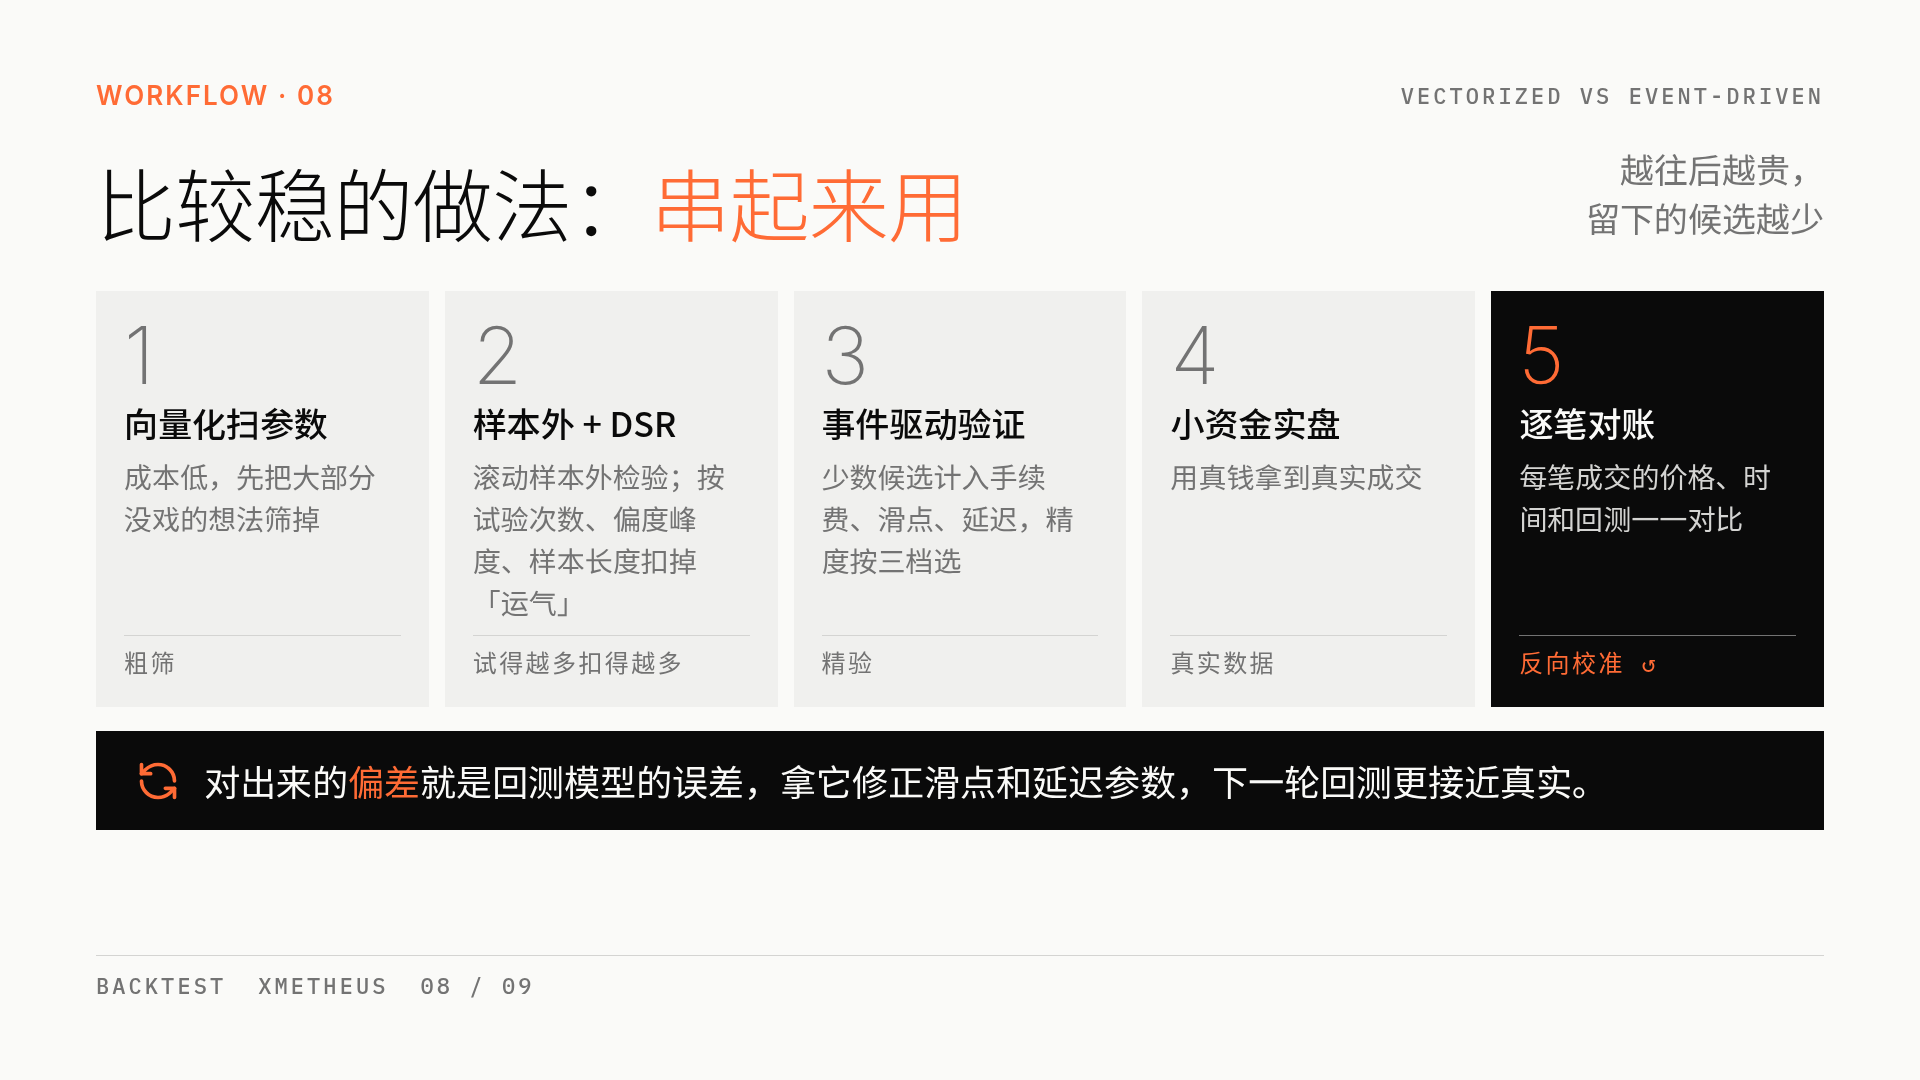
第一步,用向量化扫参数。成本低,先把大部分没戏的想法筛掉。
第二步,做滚动样本外检验,并且对夏普做多次试验校正。这一步很多人会跳过。你试了一千组参数,挑出最好的那组,它的夏普里有相当一部分是运气。Deflated Sharpe Ratio(DSR)做的就是把试验次数、收益分布的偏度和峰度、样本长度一起算进去,估计”扣掉运气之后”这个夏普还剩多少可信度。试得越多,扣得越多。
第三步,剩下的少数候选上事件驱动,把手续费、滑点、延迟都算进去,精度按上面那三档选。
第四步,小资金实盘,用真钱拿到真实成交。
第五步,逐笔对账。每笔成交的价格、时间和回测一一对比。对出来的偏差,就是你回测模型本身的误差。这个偏差可以反过来修正滑点和延迟的参数,下一轮回测就更接近真实。
番外:TradingView 属于哪种
最后说一下很多人日常在用的 TradingView。它其实也算事件驱动,只不过是按 K 线推进的那种:默认用收盘价算信号,在下一根开盘成交,K 线内部的走势只靠开高低收推算:开盘价离最高价更近,就假设先涨到最高、再跌到最低,反过来也一样。
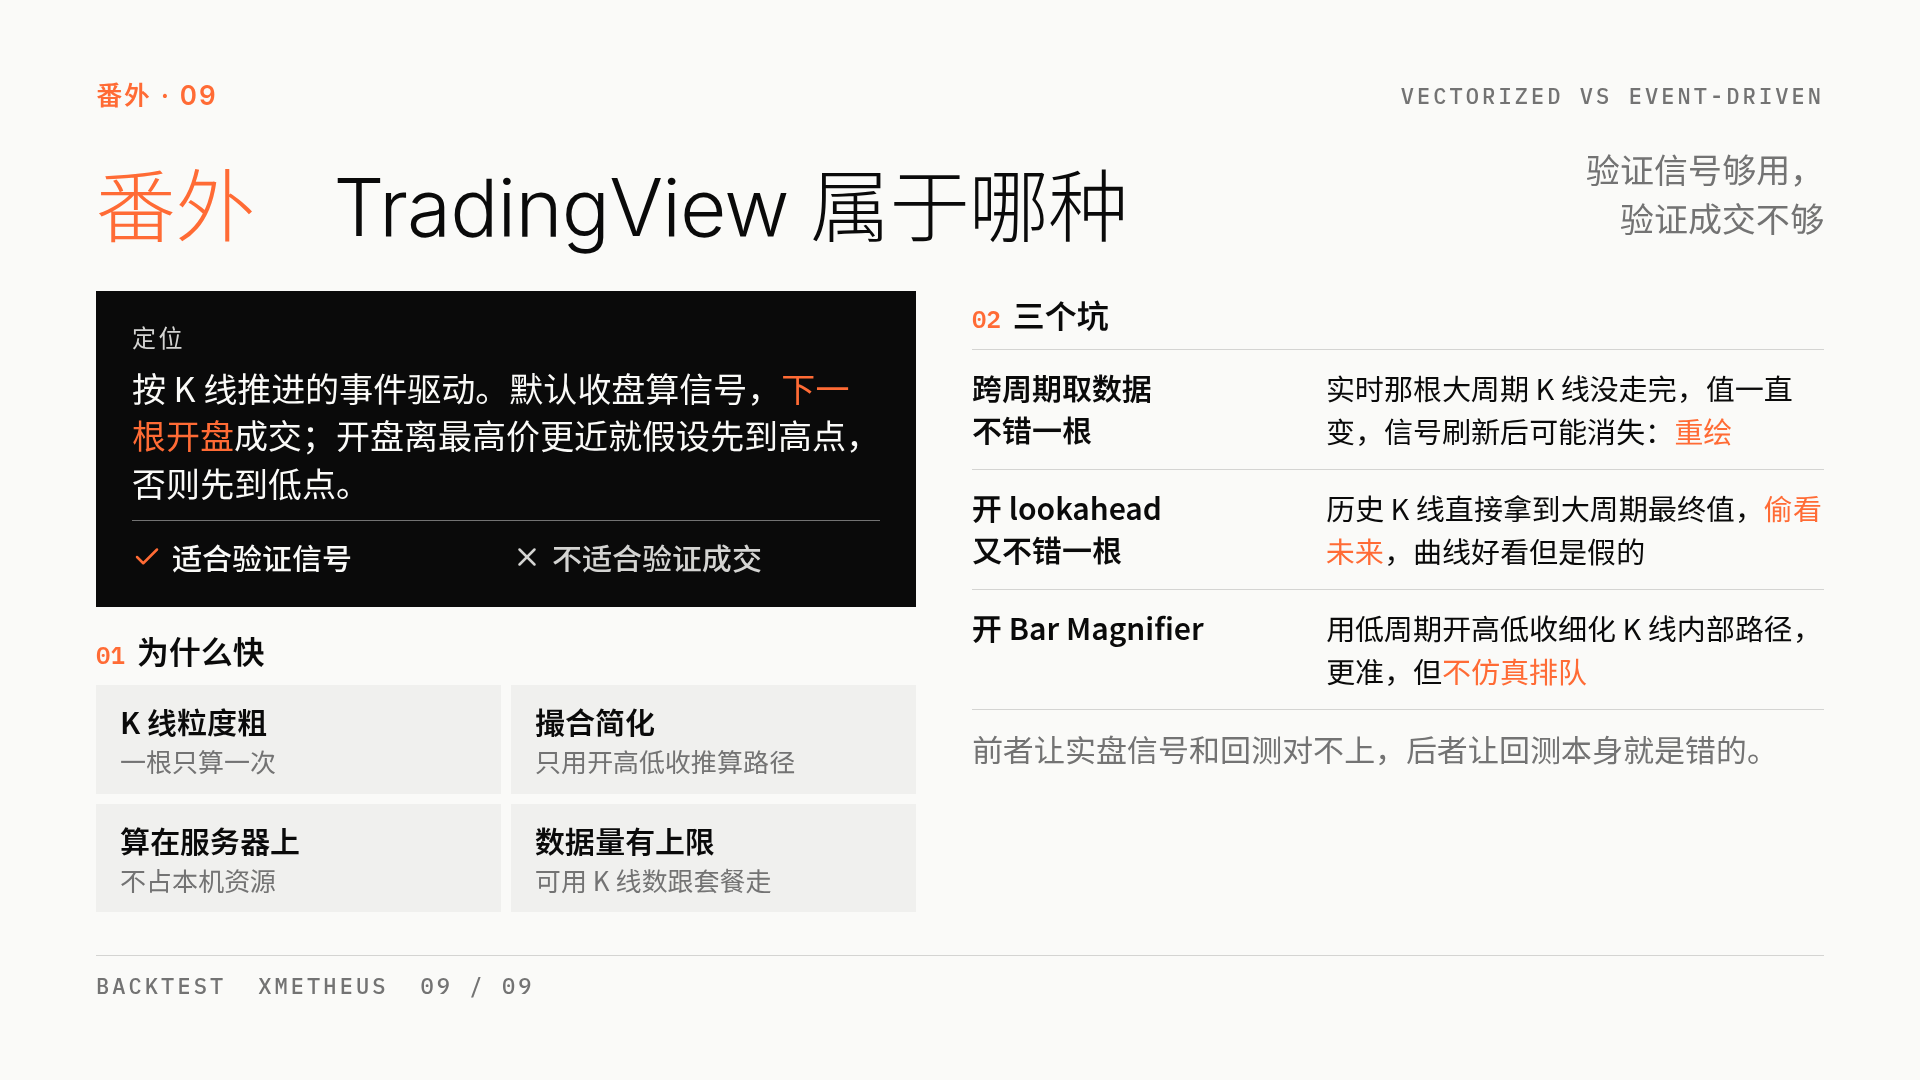
它跑得快有几个原因:K 线粒度粗,一根只算一次;撮合简化,只用开高低收推算路径;计算在它自己的服务器上;数据量也有上限,能用多少根 K 线跟你的套餐有关。
所以拿它验证信号够用,验证成交就不够。
有几个坑值得单独说:
- 跨周期取数据,不错一根会重绘。 用
request.security在小周期图上取大周期数据时,实时那根大周期 K 线还没走完,值会一直变,你看到的信号刷新之后可能就不在了。 - 开了 lookahead 又不错一根,会偷看未来。 在历史 K 线上,
lookahead会让当前位置直接拿到那根大周期 K 线最终的值,相当于提前知道了收盘价,曲线好看但是假的。正确做法是取前一根已完成的值。 - 开 Bar Magnifier 能提高精度。 它会用更低周期的开高低收去细化 K 线内部路径,比单纯推算准一些,但它依然不仿真订单排队。
这两个跨周期的问题是两回事:一个是实时 K 线上会变,一个是历史 K 线上看到了未来。前者让你实盘时看到的信号和回测对不上,后者让回测本身就是错的。
回测这件事,快和准很难同时拿到。弄清楚每种架构在假设什么,误差就知道该去哪儿找了。